Tests de non-régression par l’IA pour les applications web : ce qui fonctionne

Un tour d’horizon concret de ce qui fonctionne réellement dans les tests de non-régression par l’IA pour les applications web : sélecteurs intelligents, tests auto-réparants et cas de test générés par l’IA.
Sur cette page
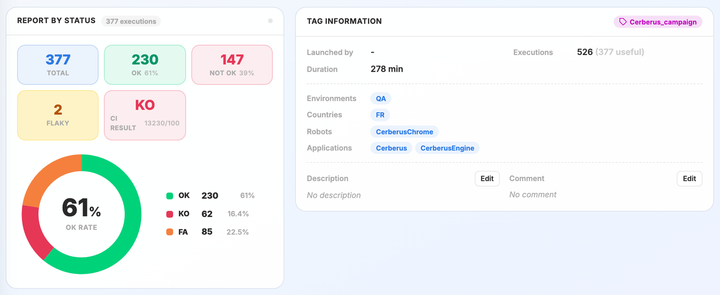
Les tests de non-régression devraient rassurer les équipes QA, pas leur donner des maux de tête. Pourtant, la plupart des équipes qui testent des applications web modernes passent plus de temps à réparer des sélecteurs cassés et à traquer des échecs intermittents qu’à détecter de vrais défauts. DOM dynamiques, applications monopages et refontes d’interface hebdomadaires transforment la suite fiable d’hier en dette de maintenance aujourd’hui.
Les tests de non-régression par l’IA promettent une porte de sortie, mais le sujet est saturé d’arguments marketing. Qu’est-ce qui fonctionne vraiment en production ? Dans cet article, nous passons en revue les trois capacités d’IA qui apportent une valeur mesurable : les sélecteurs intelligents, les tests auto-réparants et les cas de test générés par l’IA. Nous nous appuyons sur des exemples concrets tirés de Cerberus Testing, la plateforme d’automatisation open source et auto-hébergée, pour montrer comment chaque fonctionnalité se comporte sur de vraies applications web.
Pourquoi les tests de non-régression classiques échouent sur les applications web modernes#
Avant de parler d’IA, soyons honnêtes sur le problème. Les suites basées sur Selenium et les autres frameworks classiques ont été conçues pour un HTML prévisible. Les applications web modernes sont tout sauf prévisibles :
- React, Vue et Angular génèrent des noms de classes dynamiques et des identifiants éphémères.
- Les tests A/B et les feature flags modifient la structure du DOM d’une session à l’autre.
- Le chargement asynchrone crée des situations de concurrence (race conditions) que les attentes classiques ne savent pas résoudre.
- Les designers refactorisent les composants chaque semaine, ce qui casse en aval les localisateurs XPath.
Résultat : une suite de non-régression de 500 tests consacre souvent 30 à 40 % de son budget d’exécution à des tests qui échouent pour des raisons non fonctionnelles. C’est précisément cet écart que l’automatisation QA par l’IA cherche à combler.
Ce qui fonctionne vraiment : trois capacités d’IA à adopter#
1. Des sélecteurs intelligents qui survivent aux refontes d’interface#
Le principal gain de l’IA dans les tests de non-régression, c’est la résilience des localisateurs. Au lieu de dépendre d’un unique sélecteur XPath ou CSS fragile, les sélecteurs intelligents capturent une empreinte multidimensionnelle de chaque élément : balise, contenu textuel, attributs, éléments voisins, position dans le DOM et signaux visuels.
Quand la page change, l’IA attribue un score aux éléments candidats par rapport à cette empreinte et retient la correspondance la plus probable. Dans Cerberus Testing, les sélecteurs intelligents sont intégrés à l’enregistreur d’actions et proposés comme stratégie configurable. Vous pouvez combiner localisateurs classiques et solutions de repli assistées par l’IA : le moteur essaie d’abord le sélecteur que vous avez déclaré, puis bascule sur la correspondance trouvée par l’IA si l’original échoue.
Impact concret : les équipes qui migrent des suites en place depuis longtemps voient généralement les échecs liés aux sélecteurs baisser de 60 à 80 % dès le premier sprint. Ce n’est pas de la magie, simplement une correspondance plus intelligente.
2. Des tests auto-réparants qui se corrigent d’eux-mêmes#
L’auto-réparation (« self-healing ») ajoute une boucle de feedback aux sélecteurs intelligents. Lorsqu’une étape de test aurait dû échouer, le moteur répare le localisateur à la volée, journalise la modification et poursuit l’exécution. L’exécution suivante utilise le sélecteur réparé : la suite s’adapte ainsi progressivement à l’évolution de l’interface, sans intervention humaine.
Le mot-clé ici, c’est transparence. Dans Cerberus Testing, chaque réparation est enregistrée dans le rapport d’exécution avec le localisateur d’origine, le nouveau localisateur et un score de confiance. Les responsables QA examinent les modifications, les acceptent ou les rejettent, puis reportent les localisateurs validés dans la définition du test. Cette traçabilité auditable distingue des tests automatisés avec l’IA dignes de confiance des outils « boîte noire » qui modifient votre suite en silence.
3. Des cas de test générés par l’IA à partir du comportement réel des utilisateurs#
Écrire à la main une couverture de non-régression exhaustive est lent, et biaisé vers ce que les testeurs connaissent déjà. Les cas de test générés par l’IA inversent l’équation : fournissez au modèle les URL de votre application, vos user stories ou vos logs de production, et il propose des scénarios que vous pouvez relire, modifier et ajouter à la suite.
L’assistant IA de Cerberus Testing génère des étapes de test à partir de descriptions en langage naturel : un product owner peut écrire « vérifier qu’un utilisateur connecté peut ajouter un produit au panier et appliquer un code de réduction » et recevoir un test exécutable, prêt à être relu. Le même moteur analyse les tests existants pour suggérer les cas limites manquants : parcours négatifs, contrôles d’accessibilité ou valeurs aux bornes.
Le bon modèle mental n’est pas « l’IA remplace les testeurs », mais « l’IA rédige, les testeurs affinent ». La couverture progresse plus vite, et l’expertise humaine se concentre sur les parties difficiles : la logique métier, l’évaluation des risques et les tests exploratoires.
Ce qui ne fonctionne pas (encore)#
L’honnêteté compte. Certaines promesses de l’IA relèvent encore de la feuille de route plutôt que de la production :
- La conception de tests entièrement autonome à partir d’une simple URL produit des tests superficiels, limités au parcours nominal. La relecture humaine reste indispensable.
- L’IA visuelle pour toutes les assertions bute encore sur l’internationalisation, les publicités dynamiques et le mode sombre. Réservez-la aux régressions de mise en page, pas à la validation métier.
- Les assertions en langage naturel fonctionnent bien pour des vérifications simples mais atteignent leurs limites sur la validation d’états complexes. Combinez-les avec des assertions d’API structurées pour plus de fiabilité.
Considérez l’IA comme une couche de capacités, pas comme un substitut à une conception de tests solide.
Pourquoi l’auto-hébergement compte : garder vos données de test privées#
De nombreuses plateformes de test par l’IA exigent d’envoyer vos instantanés du DOM, vos captures d’écran et parfois vos identifiants vers le cloud d’un éditeur. Pour les secteurs réglementés (banque, santé, secteur public), c’est rédhibitoire.
Cerberus Testing est une plateforme de test par l’IA auto-hébergée : le moteur, la file d’attente, les exécuteurs et la couche d’inférence IA tournent dans votre propre infrastructure. Vos données de test ne quittent jamais votre VPC. Vous choisissez le LLM sous-jacent, qu’il s’agisse d’un modèle privé, d’un déploiement on-premise ou d’un endpoint managé derrière votre pare-feu. C’est cette maîtrise qui fait des tests par l’IA sans SaaS une option réaliste, et pas un simple slogan.
En pratique : une démarche d’adoption pragmatique#
Si vous partez d’une suite Selenium ou Cypress classique, voici un enchaînement qui fonctionne :
- Semaines 1 et 2 : importez vos tests existants dans Cerberus Testing. Exécutez-les tels quels pour établir une référence de l’instabilité et des échecs de sélecteurs.
- Semaines 3 et 4 : activez les sélecteurs intelligents sur les 20 tests qui échouent le plus. Mesurez la baisse du temps de maintenance.
- Semaines 5 et 6 : activez l’auto-réparation en mode fantôme (shadow mode), examinez les corrections proposées, puis passez progressivement à l’application automatique pour les changements à faible risque.
- Semaine 7 et au-delà : utilisez les cas de test générés par l’IA pour combler les lacunes de couverture révélées par les logs de production ou l’analyse de risques.
Le principe clé : mesurer avant et après. Les fonctionnalités d’IA doivent réduire les heures de maintenance et augmenter la couverture. Si une fonctionnalité n’apporte pas de bénéfice mesurable sur votre application, désactivez-la.
Les tests de non-régression en CI/CD, sans payer le prix de l’instabilité#
Rien de tout cela n’a d’importance si la suite ne peut pas s’exécuter de façon fiable dans votre pipeline. Cerberus Testing s’intègre à Jenkins, GitLab CI, GitHub Actions et Azure DevOps via une API REST. Les tests s’exécutent en parallèle sur des exécuteurs auto-hébergés, les résultats remontent en temps réel et les échecs sont automatiquement étiquetés comme fonctionnels, liés à l’environnement ou aux sélecteurs. Ce tri change à lui seul la conversation avec les développeurs : on passe de « les tests sont encore cassés » à « trois vrais défauts, deux problèmes d’environnement, zéro sélecteur cassé ».
Faites l’essai sur votre propre application#
Les tests de non-régression par l’IA ne sont plus un sujet de recherche. La combinaison des sélecteurs intelligents, de l’auto-réparation et des cas de test générés par l’IA est aujourd’hui en production, et l’approche open source et auto-hébergée lève les objections sur les données et la dépendance à un éditeur qui freinaient l’adoption.
Pour voir ce que cela donne sur votre propre application web, découvrez le projet Cerberus Testing sur GitHub (s’ouvre dans un nouvel onglet), déployez une instance locale et importez votre première suite de non-régression. Le moyen le plus rapide d’évaluer l’IA en QA, c’est de la confronter à des tests que vous connaissez déjà.